Tradução jurídica tem uma assimetria desconfortável: o prazo aperta e o erro custa caro. Um contrato com o termo trocado não é problema de estilo. É problema que aparece semanas depois, na mesa de outra pessoa, quando já não dá para corrigir de graça.
Com 608 clientes e mais de 12.600 projetos acumulados, fazer isso à mão significa contratar tradutor atrás de tradutor — e mesmo assim o gargalo se desloca para a revisão. Montei o Mt-service para responder a uma pergunta específica: dá para automatizar tradução técnica sem abrir mão do controle de qualidade que o jurídico exige? Ele está em produção contínua desde 2025 e é o projeto de maior longevidade que eu mantenho de pé.
Traduzir mais rápido, sozinho, não resolve nada em documento jurídico
Tradução automática rápida sem QA é risco com outro nome. Você troca o tempo do tradutor pelo tempo de quem vai descobrir o erro depois, e o segundo costuma sair mais caro que o primeiro.
O problema de verdade tinha quatro partes que precisavam caber no mesmo fluxo: traduzir, aplicar a terminologia daquele cliente, revisar editorialmente e passar por QA. Qualquer uma delas feita à mão vira o gargalo do conjunto. Automatizar só a tradução muda o gargalo de lugar e a operação continua do mesmo tamanho.
E tinha uma restrição inegociável: o resultado precisava caber no fluxo de trabalho que o setor já usava. Em localização isso quer dizer SDL Trados, que é o padrão da indústria. Um sistema que exigisse abandonar o Trados não seria adotado, por melhor que rodasse.
Seis passes por documento, e o último é uma pessoa
A porta de entrada é FastAPI. Os endpoints recebem os segmentos de tradução vindos do próprio SDL Trados. O tradutor continua trabalhando na ferramenta dele, e o pipeline entra como mais uma etapa — não como um sistema paralelo que alguém precisa lembrar de abrir.
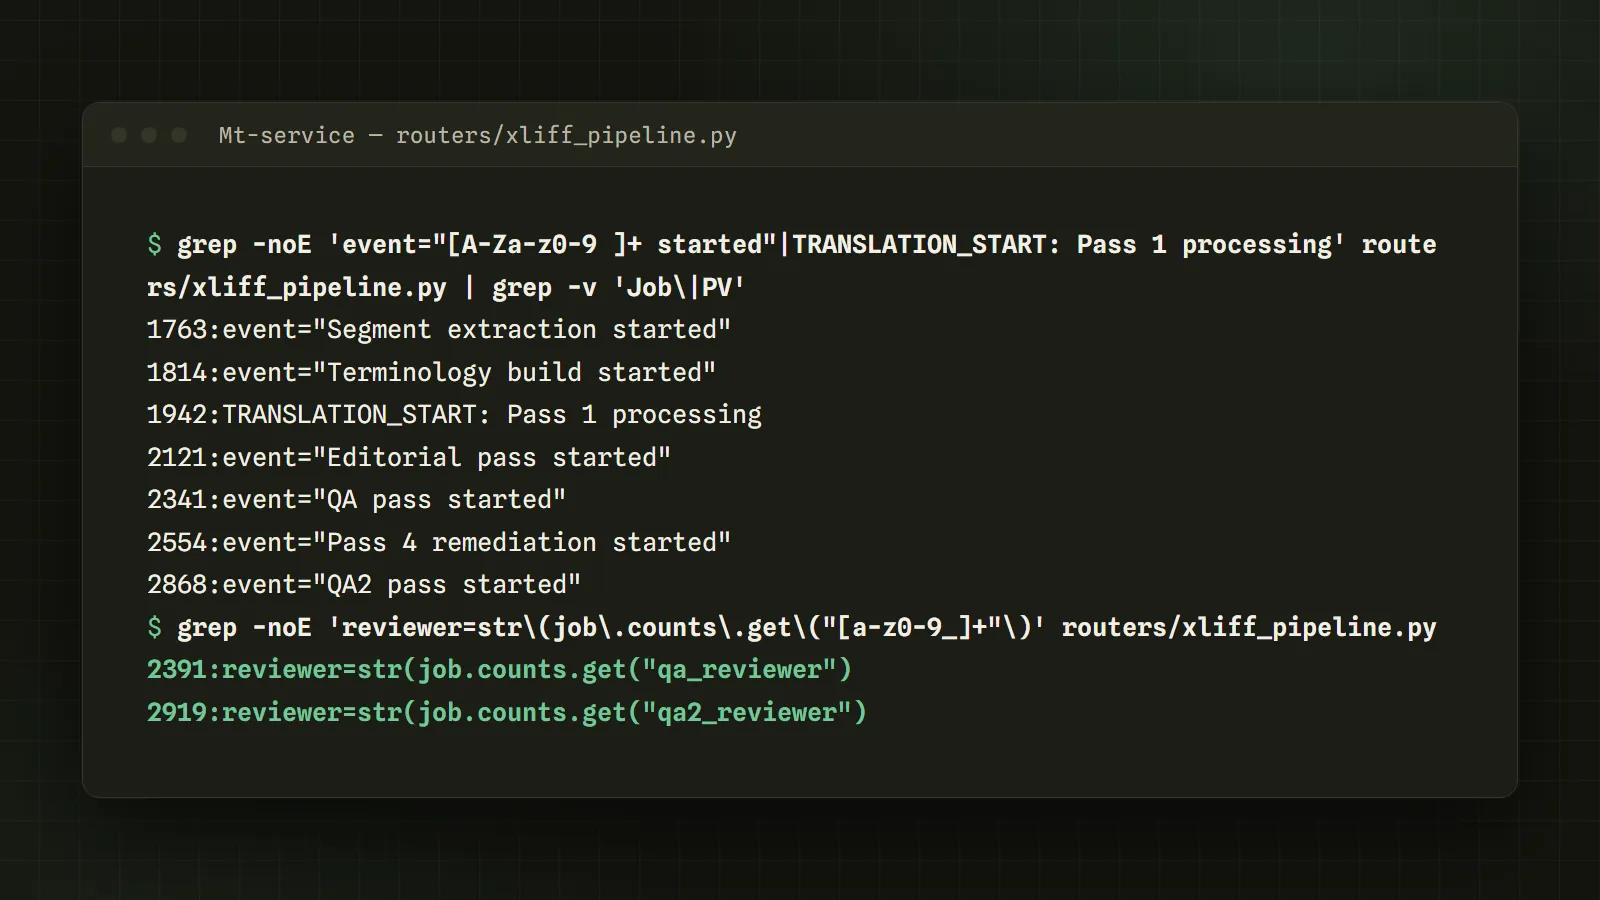
Dentro, cada documento passa por seis etapas em ordem: extração dos segmentos, injeção da terminologia do setor, tradução via LiteLLM, revisão editorial, QA automatizado e checkpoint humano final. O spaCy faz o trabalho linguístico do processamento e o WeasyPrint gera o relatório no fim. O backend roda em Railway; o frontend administrativo, em Vercel.
Glossários e memórias de tradução ficam indexados por cliente. É a parte que menos parece IA e mais parece burocracia, e é a que separa uma tradução aceitável de uma tradução que o cliente reconhece como dele. Dois clientes do mesmo setor usam palavras diferentes para a mesma coisa, e nenhum dos dois trata isso como detalhe.
Custo, tempo e erros são rastreados por job, e 100% dos jobs saem com relatório. Isso não é enfeite de dashboard: é o que permite responder "o que aconteceu neste documento" sem reabrir o documento e refazer o caminho na mão.
LEIA TAMBÉM · TutorialComo traduzir documentos com IA em 5 passadas, e não em umaUm prompt só traduz até aparecer um termo que não pode variar ou uma expressão que soa estranha. Este pipeline passa o texto por cinco etapas, cada uma corrigindo um tipo de erro, e no fim gera um relatório do que mudou.O erro não costuma vir do modelo, vem do glossário parado
Pipeline de tradução multi-passe com terminologia por cliente surpreende em dois pontos, e nenhum deles é o modelo escolher a palavra errada por conta própria.
O primeiro é o glossário desatualizado. O cliente mudou o termo padrão em algum momento, ninguém avisou o pipeline, e o modelo segue o glossário à risca — que é exatamente o que você pediu que ele fizesse. O resultado sai consistente, rastreável e errado. Erro consistente é mais difícil de achar do que erro aleatório. Ele não chama atenção em nenhuma linha específica — chama no documento inteiro, e só quando alguém do cliente lê com calma.
O segundo é o segmento fora de contexto. O Trados manda frases isoladas, e uma frase isolada perde o sentido que o parágrafo inteiro dava. O modelo traduz corretamente o que recebeu, e o documento montado fica com uma linha que não conversa com a anterior. Nenhum dos dois casos aparece como falha no log. Os dois aparecem como tradução plausível, que é a categoria mais cara de erro.
15× mais rápido e 95% mais barato, com duas peças que nunca desligam
Os números que eu tenho são comparativos, não absolutos: o pipeline roda 15× mais rápido e 95% mais barato que o processo anterior. Não publico um custo mensal em reais, e o "antes" também não está fechado em número. O que está fechado é a razão entre os dois, e é ela que decide se o pipeline se paga.
Dentro desse custo, dois passes de QA acontecem antes de qualquer entrega. Não são opcionais nem proporcionais ao tamanho do documento, porque o dia em que alguém decide pular o QA é sempre o dia do documento urgente — e documento urgente é onde o erro mora.
A estrutura de gasto tem duas naturezas. Railway e Vercel ficam ligados o tempo todo, e essa parte é fixa, independente de volume. As chamadas de modelo via LiteLLM variam com o número de segmentos e com quantos passes cada documento exige. Em volume baixo o custo fixo domina e o pipeline parece caro demais para o que faz. Na casa dos 12.600 projetos, a conta se inverte.
LEIA TAMBÉM · Caso realComo construí mais de 25 sistemas de IA sozinho em seis mesesAntes de escrever código, eu escrevo um documento dizendo o que o sistema faz e como saber se deu certo. Depois viro isso num plano de passos. A IA acelera muito a construção, mas só quando essa definição existe.Eu trataria a atualização de glossário como parte do QA, não como manutenção
Com 608 clientes, cada um com a própria terminologia, glossário é um ativo que envelhece sozinho. Ninguém acorda com vontade de revisar glossário, e o custo de não revisar só aparece traduzido, dentro de um documento que já foi para o cliente.
O que merece instrumentação cedo é uma pergunta curta: quando o glossário deste cliente mudou pela última vez e quantos jobs rodaram desde então. É uma consulta, não um projeto. E cobre justamente o ponto cego do relatório por job — o relatório mostra o que o pipeline fez, não mostra que a regra seguida por ele está velha.
Velocidade em tradução automatizada é a parte fácil de prometer e a parte fácil de conseguir. O que sustenta 12.600 projetos em produção desde 2025 não é o modelo ser rápido: é o QA rodar duas vezes em todo job e sair relatório de 100% deles, sem exceção por urgência. Sem esse rastro, você não tem um processo 95% mais barato. Tem uma aposta com prazo curto e testemunha nenhuma.